
Eigen modellen. Eigen hardware. Eigen data.
Wij ontwerpen, bouwen en installeren on-premise NVIDIA-servers voor training en inferentie — en blijven daarna het team dat ze snel, stabiel en actueel houdt, hoe sterk de stack ook verandert.
Werkwijze
Hoe het werkt
Drie stappen.
Intakegesprek
Wat er moet draaien, waar u tegenaan loopt, wat uw randvoorwaarden zijn. Als self-hosting voor uw situatie het verkeerde antwoord is, zeggen we dat in dit gesprek.
Wij ontwerpen en bouwen het
Of we pakken uw vastgelopen project op waar het is blijven liggen. Workloadanalyse, benchmarks, hardwareselectie, inkoop, bouw, tuning, installatie. U krijgt werkende hardware, geen onderdelenlijst.
Wij houden het draaiend
Het supportcontract begint. U gebruikt uw hardware; wij houden alles erop actueel — modellen inbegrepen.
Waarom self-hosten
Herkent u een van deze situaties?
Wilt u zelf de controle over uw data?
Medische dossiers, juridische stukken, financiële gegevens — wie vertrouwelijke informatie verwerkt, laat die liever niet door het inference-endpoint van een ander lopen. Vroeg of laat vraagt een klant waar zijn data heen gaat, en dan wilt u een beter antwoord hebben dan een verwijzing naar andermans voorwaarden.
Met self-hosting vervalt die vraag. Uw data blijft binnen uw eigen muren: geen gedeelde omgeving, geen derde partij, geen grijs gebied in uw verwerkersovereenkomst.
Houdt regelgeving u uit de cloud?
Voor sommige organisaties valt hier niets te kiezen. Sectorregels, aanbestedingseisen of een getekende verwerkersovereenkomst verbieden simpelweg dat er data naar een externe partij gaat — hoe goed die partij zijn beveiliging ook op orde heeft. En omdat de meeste grote inference-API's in handen zijn van niet-EU-bedrijven, begint bij elk verzoek de vraag of er sprake is van doorgifte — en op die vraag moet u het antwoord klaar hebben.
Is dat uw situatie, dan is on-premise niet de voorzichtige keuze maar de enige. Hardware in uw eigen gebouw, onder Nederlands recht — en het antwoord is opeens simpel. Wij nemen die randvoorwaarde als uitgangspunt en documenteren de hele opzet, zodat uw compliance officer iets concreets heeft om af te tekenen.
Lopen uw tokenkosten op?
Betalen per token is prima zolang u experimenteert. Maar draait een workload eenmaal dag in dag uit, dan begint elke maandafrekening te knellen — en zijn er teams die liever één keer investeren dan eindeloos naar de teller kijken.
Of eigen hardware voor u goedkoper is, hangt af van één ding: hoe constant uw gebruik is. Dat rekenen we door met uw eigen cijfers — en is het antwoord nee, dan hoort u nee. Een terugverdientijd beloven we niet op een website.
Trekt uw provider de modellen onder u vandaan?
Gehoste modellen worden uitgefaseerd, uitgezet en tussendoor stilletjes bijgewerkt. Uw prompts zijn afgestemd op gedrag dat er morgen anders uit kan zien, uw evals verschuiven zonder dat u ziet waarom, en wanneer u moet migreren bepaalt iemand anders.
Een open-weights-model op eigen hardware verandert pas wanneer ú dat besluit — geen dag eerder. En komt er iets dat écht beter is, dan meten wij het en hoort u het van ons.
Haalt u alles uit de hardware die u al heeft?
De meeste zelfgehoste omgevingen draaien op standaardinstellingen: het BIOS zoals het uit de fabriek kwam, de serving-runtime die toevallig als eerste is geïnstalleerd, een configuratie die hooguit één keer is getuned — op een workload die inmiddels veranderd is. Het draait, en juist daarom kijkt niemand er nog naar om.
Terwijl het verschil tussen zo'n standaardopstelling en een goed getunede, op exact dezelfde hardware, vaak fors is. Wij maken dat verschil zichtbaar met isobench, ons eigen benchmarkframework: we meten over BIOS- en firmware-instellingen, driverversies, serving-stacks en modelconfiguraties heen, en zetten wat uw hardware kán naast wat hij nu doet.
Soms komt daaruit dat er een node bij moet. Vaker van niet.
Zelf hosten betekent wél: zelf hardware kiezen, zelf stroom en koeling regelen, zelf firmware en drivers bijhouden, en zelf iemand hebben die het oplost als het kapotgaat.
Dat is het deel dat wij doen.
Realisatie
Het draaiend krijgen
U vertelt ons wat u wilt trainen of serveren. Wij leveren werkende hardware op, met uw workload er al op — en met de prestaties die erbij horen.
| 1. De workload in kaart | Modelgroottes, batchvormen, doorvoer- en latencydoelen, concurrency, contextlengtes, en hoe dat alles naar verwachting groeit. Vóórdat er over hardware wordt gesproken. |
| 2. Het systeem ontwerpen | De GPU-server is maar een van de onderdelen. Inference-gateway en request-routing, authenticatie en rate limiting, storagelagen voor weights, datasets en checkpoints, netwerktopologie en bandbreedte tussen nodes, observability, back-up en failover — en hoe dat alles aansluit op de omgeving die u al draait. |
| 3. De hardware selecteren | GPU-keuze, hostplatform, CPU, RAM, NVMe-lagen, interconnect, stroom- en koelingsruimte — gedimensioneerd op de workload en het ontwerp hierboven, en onderbouwd met metingen in plaats van datasheets. Wij nemen geen marge op hardware, dus de aanbeveling is de configuratie die past, niet de configuratie waar wij het meest aan verdienen. |
| 4. Inkopen en bouwen | Er wordt niets besteld voordat u het ontwerp en de stuklijst heeft goedgekeurd. Daarna sourcing, levertijdbeheer, assemblage, firmware, thermische validatie en duurtests onder belasting voordat er productieverkeer op komt. |
| ⋯ | Stack-tuning, OS- en driverconfiguratie, keuze en vlaggen van de serving-runtime, orkestratie, deployment, integratie, benchmark-baseline, runbooks, overdracht — en nog het nodige meer. Het echte proces is aanzienlijk langer dan een tabel op een website; wij nemen de delen die er voor uw situatie toe doen met u door. |
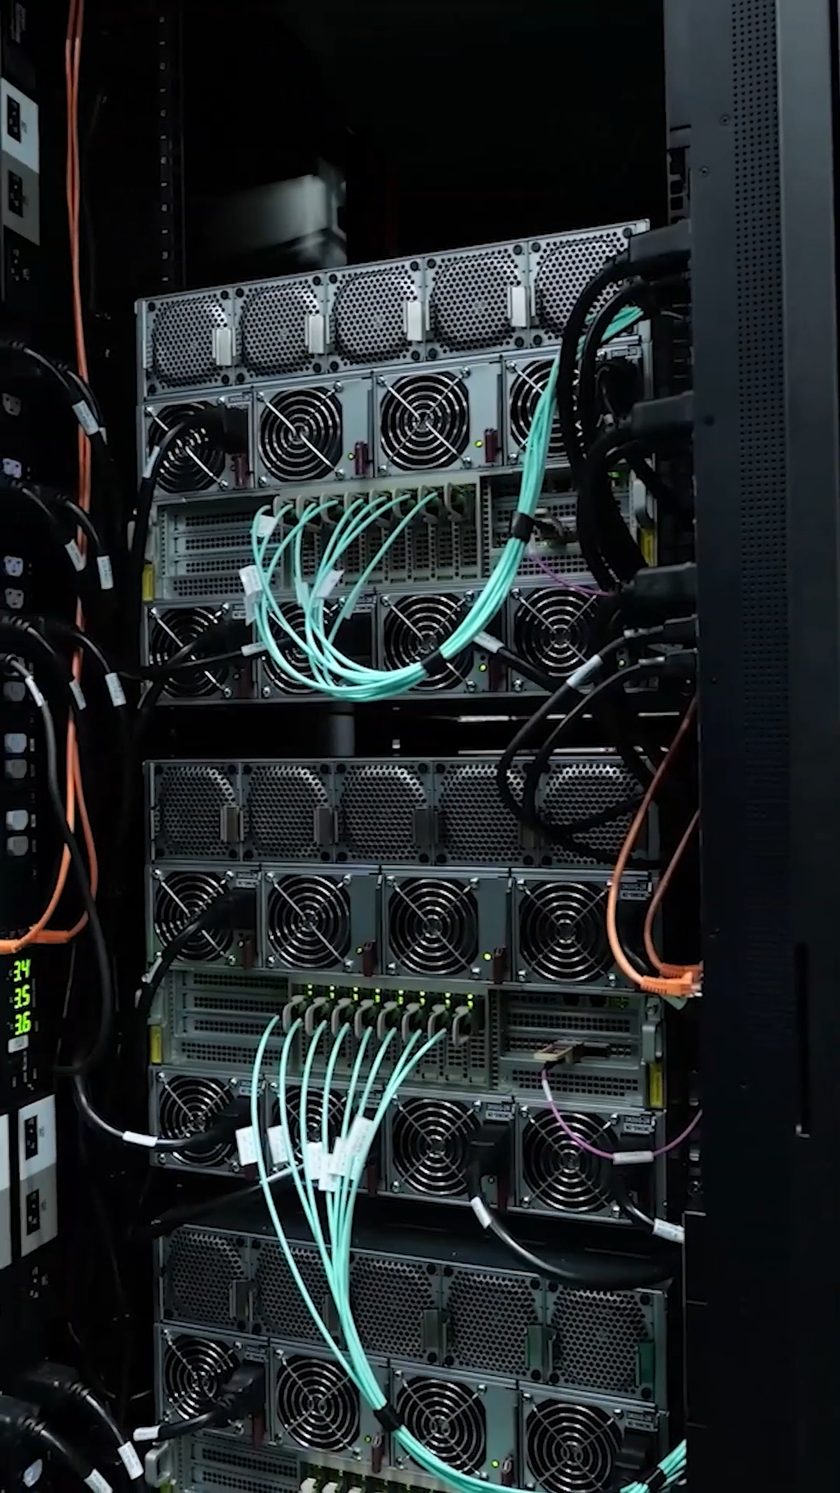
Typische builds
Een groot open-weights-model onder echte concurrency serveren vraagt meer hardware dan de meeste teams verwachten.
8-GPU-datacenternode (HGX-klasse, H200 / B200)
De grootste open-weights-modellen onder echte concurrency, en serieuze training op één node. Dit is wat er nodig is om ze goed te serveren.
Multi-node-cluster
Meerdere nodes plus een snelle fabric en gedeelde storage, voor gedistribueerde training of een inference-vloot die niet plat mag.
Losse server (1–4 GPU's)
Kleinere modellen, fine-tuning, on-prem RAG, of een pilot voordat u zich op een volledige node vastlegt.
Drie vormen, geen menukaart. Lijkt uw workload op geen van drieën, dan is dat precies waar het intakegesprek voor is — en soms is het eerlijke antwoord: iets kleiners dan alle drie.
Doorlooptijd. Wij werken in uw tempo. GPU-levertijden zijn de grootste variabele en die heeft niemand in de hand, maar sourcing kunnen we vaak versnellen — en u krijgt in het intakegesprek een realistische inschatting, geen rooskleurige belofte op een website.
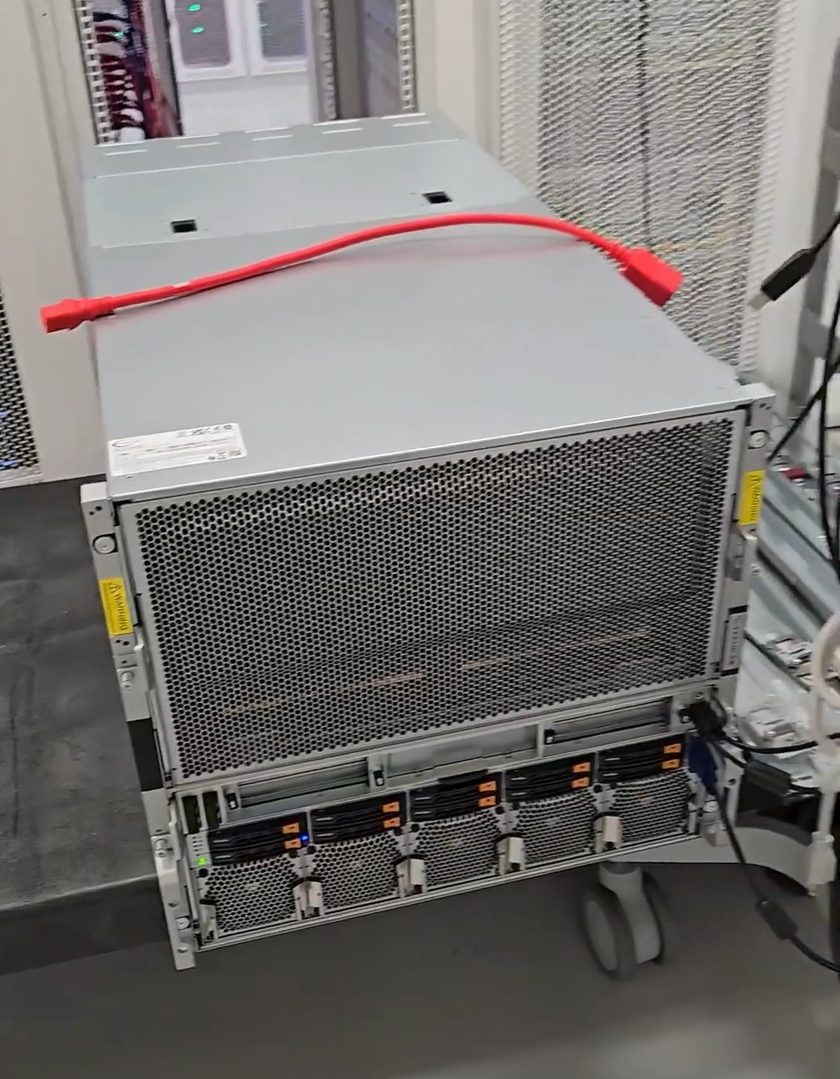
Vastgelopen projecten
Hardware al gekocht en het project ligt stil?
Het komt vaak voor. De servers zijn geleverd, degene die het project trok is vertrokken of van team gewisseld, en nu draait er dure hardware op een fractie van wat hij kan — of staat hij helemaal niet in productie. Niemand weet meer precies wat er besloten is of waarom.
Wij pakken dit op. We zoeken uit wat u heeft, wat er geconfigureerd is en wat niet, waar de prestaties weglekken, en wat vanaf dit punt de snelste route naar productie is. U krijgt een helder beeld van waar het project werkelijk staat en een plan om het af te maken.
Geen oordeel over hoe het zo gekomen is. Zo gaat het bij zelfgehoste AI-infrastructuur het vaakst mis, en het is zelden iemands schuld — de stack is nu eenmaal lastig en verandert sneller dan de meeste teams kunnen bijhouden.
Supportcontract
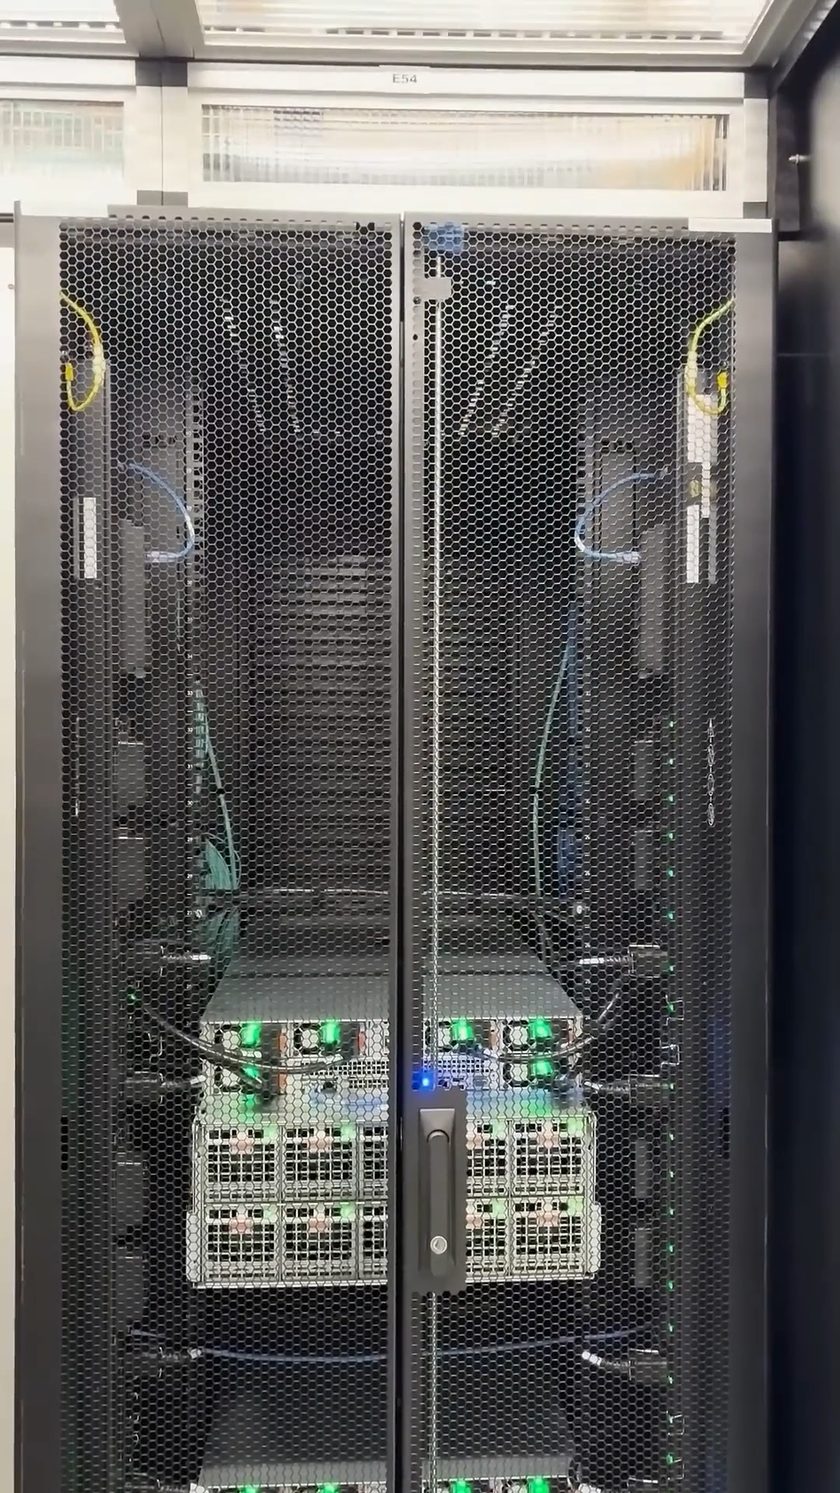
Actueel houden
Hardware is de makkelijke helft. Nieuwe open-weights-modellen en serving-software verschijnen doorlopend, en een server die niemand onderhoudt wordt stilletjes een risico.
De configuratie die bij oplevering optimaal was, is dat over drie maanden niet meer. Er verschijnt een nieuw model dat voor hetzelfde geld beter is dan wat u draait. SGLang brengt een feature uit die precies úw workload sneller maakt. Een nieuwe driver verandert de doorvoer.
Bijna niemand heeft tijd om dat bij te houden, te benchmarken en te beslissen of het het migratierisico waard is. Wij doen dat als vast onderdeel van ons werk — en u hoort het wanneer overstappen de moeite waard is, niet bij elke release.
Eén contract. Geen tiers, geen aparte adviesbundel, geen facturen per incident — want het waardevolste wat we doen is u vertellen wanneer er iets beters bestaat, en dat hoort niet achter een betaalmuur.
- Monitoring en alerting GPU-benutting, geheugen, temperaturen, ECC-fouten, doorvoer, en afwijking van uw benchmark-baseline. Wij houden het in de gaten, zodat uw engineers dat niet hoeven te doen.
- Patches en upgrades Firmware, drivers, CUDA, kernel, containerruntime, serving-stack. Getest voordat het in productie gaat.
- Herijken en tunen Als uw verkeerspatroon verandert, klopt de configuratie van de oplevering niet meer. Wij passen hem aan.
- Runtime- en modeladvies Wanneer een nieuwer model of een nieuwe runtimerelease uw huidige opstelling meetbaar verslaat, hoort u het van ons, met cijfers en een advies over timing. Geen nieuwsbrief.
- Migratiesupport Als overstappen de moeite waard is, voeren wij de migratie uit.
- On-call incidentrespons Inbegrepen, geen extra module. Responstermijnen worden in uw contract vastgelegd.
- Capaciteitsplanning Wij zien maanden van tevoren aankomen dat u een extra node nodig heeft — u hoort het vóórdat het urgent is.
- Hardwarelevenscyclus Garantie- en RMA-afhandeling, een reservedelenstrategie afgestemd op hoeveel downtime u zich kunt veroorloven, en een eerlijk antwoord op de vraag wanneer vernieuwen loont en wanneer wachten.
Wij draaien deze stack bij meerdere klanten. Wanneer een nieuw model, een runtime of een driver de upgrade werkelijk waard is, hebben we dat meestal al ergens anders gemeten. U profiteert van die experimenten zonder ervoor te betalen.
Niet gissen, maar meten.
Hoe snel een systeem uiteindelijk draait, hangt af van een lange rij keuzes die op elkaar inwerken — en die rij begint bij de inkoop, niet bij de installatie: GPU en hostplatform, interconnect, lucht- of vloeistofkoeling, BIOS- en firmware-instellingen, OS-configuratie, driver- en CUDA-versies, de serving-runtime en de vlaggen waarmee hij draait, kwantisatie, batchingstrategie, en het model zelf. Verander er één, en de rest schuift mee. Leveranciersbenchmarks zeggen niets over úw workload, en combinaties met de hand testen houdt bij een handvol op.
Dus bouwden we isobench — ons eigen framework om benchmarks systematisch te draaien over BIOS-instellingen, OS- en driverconfiguraties, serving-stacks en modellen heen, en de resultaten naast elkaar in beeld te brengen.
- Hardware-aanbevelingen op basis van metingen Geen leveranciersdatasheets of aannames over wat snel zou moeten zijn. Wilt u het bewijs vóór de bestelling, dan huren wij de kandidaat-GPU's in de cloud en draaien we uw workload erop.
- Een getunede configuratie, geen standaardinstellingen Wij zoeken de instellingen die bij uw workload passen, in plaats van te laten staan wat de installatie achterliet.
- Een baseline waar u ons aan kunt houden U weet wat uw hardware doet als hij gezond is, dus een regressie valt meteen op.
- Upgraden met bewijs in de hand Ziet een nieuwe runtimerelease of een nieuw model er veelbelovend uit, dan meten we eerst tegen uw eigen baseline — en adviseren we daarna pas een overstap.
Met elke klantdeployment groeit wat we gemeten hebben. Die kennis stapelt zich op — en daarom worden onze aanbevelingen met de tijd beter in plaats van gedateerd.
Waarom wij
Waarom isocline
- Wij doen beide helften. Integrators verkopen u ijzer. Consultants verkopen u een slidedeck. Wij bouwen de machine en houden hem daarna zelf draaiend.
- Wij meten in plaats van te gissen. Dankzij ons eigen benchmarkframework is de configuratie die u draait, de configuratie die voor uw workload het best uit de test kwam.
- Geen hardwaremarge. Wij verdienen niet aan de onderdelen — daarom kunnen we er leveranciersneutraal over zijn, en daarom adviseren we u met plezier minder GPU's dan waar u om vroeg.
- Wij dimensioneren eerlijk. Te veel GPU's verkopen levert de makkelijkste marge in dit vak op — en is de snelste manier om een klant te verliezen.
- Wij praten het u ook uit het hoofd. Sommige workloads horen echt in de cloud — grillig, onvoorspelbaar, of te klein om de investering te rechtvaardigen. Dat zeggen we liever dan u een rack te verkopen dat u niet nodig heeft.
- Nederlands, en dat blijft zo. Uw hardware, uw locatie, Nederlands recht.
Vragen
Veelgestelde vragen
Wij hebben geen datacenter. Kan dit dan toch?
U heeft er geen nodig. Voor alles van HGX-klasse is een Nederlands colocatiedatacenter onze standaard — u blijft volledig eigenaar van de hardware, hij staat gewoon in Nederland en valt gewoon onder Nederlands recht. Self-hosting draait niet om het gebouw.
Wij vinden de faciliteit, vertellen u welke eisen u moet stellen voordat u tekent, ontwerpen het rack en begeleiden de migratie. Twee dingen die klanten zelden verwachten: een colocatiedatacenter valt in een lagere energiebelastingschijf dan uw eigen pand bij identieke stroom, en nu het stroomnet in grote delen van het land vol zit, is colocatie deels een manier om een aansluiting te kopen die u anders niet krijgt.
Dat geldt ook voor pilots — een kleine deployment heeft geen vol rack nodig, en wij houden het rack zo groot als de build vraagt, in plaats van u ruimte aan te praten die u niet gebruikt.
Welke modellen kunnen we draaien?
Elk open-weights-model dat past binnen de geheugenruimte waarvoor we ontwerpen — en we ontwerpen voor de modellen die u noemt plus ruimte voor wat erna komt. We hebben gewerkt met Llama, Qwen en Mistral/Mixtral — inclusief de grote mixture-of-experts-modellen.
Wij hebben al servers. Kunt u ons helpen er meer uit te halen?
Ja. Bestaande hardware en vastgelopen projecten oppakken is voor ons een normale opdracht, en vaak de snelste winst die er te halen valt.
Wie is eigenaar van de hardware?
U, volledig. Wij rekenen er geen marge op en nemen hem nooit in eigendom.
Wat als we eruit groeien?
Capaciteitsplanning is onderdeel van het supportcontract, dus u weet het maanden van tevoren. Nodes toevoegen aan een cluster dat wij hebben gebouwd is rechttoe rechtaan, omdat we de fabric daarop hebben ontworpen.
Kunt u samenwerken met ons eigen infrastructuurteam?
Dat is de normale gang van zaken. Wij doen de GPU-laag en leveren documentatie waar uw team echt iets aan heeft.
Ondersteunt u hybride opstellingen?
Ja, in beide vormen. Eigen hardware voor de constante belasting met cloud-burst voor pieken is vaak de verstandigste opzet. Net als een ontwikkelmachine van workstationklasse bij u op locatie met de productienode in colocatie — iets tastbaars om aan te werken, zonder een machine van 10 kW in een kantoor te zetten.
Wat gebeurt er als een GPU uitvalt?
Garantie- en RMA-afhandeling zijn onder het supportcontract onze taak. We ontwerpen vooraf ook een reservedelenstrategie met u, afgestemd op hoeveel downtime u zich kunt veroorloven.
Is self-hosting goedkoper dan cloud-GPU's huren?
Soms, en het hangt volledig af van hoe constant uw workload is. We beloven u vooraf geen getal — we rekenen het door met uw werkelijke gebruik en zeggen het eerlijk als het antwoord nee is.
Over ons
Eén team voor het hele probleem.
Zelfgehoste AI-infrastructuur loopt meestal stuk op de raakvlakken. De hardware wordt gespecificeerd door het ene team, dat de workload nooit gaat draaien. OS, firmware en drivers worden geconfigureerd door een tweede team, dat de hardware niet heeft gekozen. De serving-stack wordt uitgerold door een derde, dat beide aantreft zoals ze zijn en geen van beide nog kan veranderen. Elk onderdeel is op zichzelf verdedigbaar, en toch blijft de helft van de prestaties liggen.
isocline is dat ene team.
Erik
Verantwoordelijk voor het assessment, de dimensionering en de aanbeveling die eruit volgt — ook wanneer de eerlijke aanbeveling een kleinere build is dan waarvoor u kwam.
David
Infrastructuur, bij elke build. Besturingssysteem, firmware, drivers, kernelupdates, storage, monitoring, systeembelasting. Alles tussen het ijzer en het model, en het deel dat bepaalt of de machine over een jaar nog snel is.
Bjorn
Applicatielaag, bij elke build. De serving-stack geselecteerd en getuned tot de snelst gemeten configuratie voor uw workload, en de gateways ervoor — redundant, zodat geen enkele storing de dienst platlegt.
Een vaste engineer
Voor de softwarekant krijgt elk project voor de duur ervan een engineer toegewezen, onder leiding van Bjorn: de serving- en trainingsstack, de gateway- en routinglaag ervoor, benchmarkontwerp, en de tuning die van een correct gebouwde machine een snelle maakt. Eén engineer, één project — geen wachtrij.
De specialisten
Datacenter-installatieploegen, en twee engineers met een achtergrond in embedded en toegepaste-wiskunde-ML voor werk dat dieper gaat dan het framework — hardwarespecifieke inference-engines tot op de kernels, voor klanten die de laatste meetbare procenten uit hun aanschaf willen halen.
Eén aanspreekpunt
Degene die u als eerste spreekt, blijft erbij — tijdens het assessment, de bouw en de supportjaren daarna. Iemand die uw omgeving kent, die u bereikt als het erom spant, en die niet halverwege wisselt.
Iedereen hier is engineer. Er zit geen accountmanager tussen, en niemand die eerst met het technische team moet overleggen voordat u antwoord krijgt.
Waar we werken
Wij werken in de datacenters waar de hardware staat, en daarbuiten op afstand. We houden er geen kantoor op na om klanten te ontvangen — voor dit werk doet maar één adres ertoe: dat van de machines.
Certificeringen
Het team is gecertificeerd door de fabrikant van de hardware waarmee wij bouwen: voor het ontwerpen en beheren van AI-infrastructuur, en voor het werken met generatieve modellen en LLM's. Beide certificaten zijn online te controleren — infrastructuur en beheer en generatieve AI en LLM's.
Contact
Vertel ons wat er moet draaien.
Kom met uw workload, uw randvoorwaarden en uw vragen — of met de hardware die u al heeft en niet aan de praat krijgt. U krijgt een eerlijk antwoord op de vraag of self-hosting voor u zinvol is, en zo niet, dan zeggen we dat.
Of mail → intake@isocline.nl
Overige vragen → info@isocline.nl